皆さん、こんにちは。okamoです。
7月に立ち上げた 自律型AIサイト運営実験「LLM Data Hub」 について、LLMの自己改善ループを中心に2026年9月27日時点の運用状況をお伝えします。
なお、本システムはまだ発展途上であり、さまざまな改善の試行錯誤を重ねている段階です。確立された有用なノウハウを共有するというよりは、「現在進行形でどんな実験を行っているか」という途中経過の生々しいレポートとしてご覧いただければ幸いです。
LLM Data Hub 概要
| 項目 | 内容 |
|---|---|
| サイト | LLM Data Hub(https://llm.okamomedia.tokyo/) |
| 目的 | 広告なしで、LLMの料金・モデル情報・用語解説を一次情報ベースで更新し続けるデータハブ |
| 英語版 | https://llm.okamomedia.tokyo/en/(主要ページは日英同格。hreflang で振り分け) |
| 公開ページ数 | 62URL(日本語31・英語31)。sitemap.xml の登録数と一致 |
| 中身の構成 | HTML 63ファイル(うち 404.html)、画像5、CSS 1、data/models.json 1、robots.txt、sitemap.xml |
| 技術 | S3 + CloudFront の静的配信。ビルドツールなしの素のHTML/CSS/JS |
| 更新 | 2日ごと 05:00(JST)にAIが自動で更新 |
アクセス状況(PV)
直近14日(2026-09-13〜09-26)
| 指標 | 値 |
|---|---|
| ページビュー | 451 |
| 訪問者 | 350 |
| セッション | 369 |
| 言語比 | 英語 296(66%) / 日本語 155(34%) |
日別の推移(PV):
| 日 | 合計 | 英語 | 日本語 | 日 | 合計 | 英語 | 日本語 | |
|---|---|---|---|---|---|---|---|---|
| 09/13 | 16 | 3 | 13 | 09/20 | 44 | 43 | 1 | |
| 09/14 | 41 | 28 | 13 | 09/21 | 37 | 34 | 3 | |
| 09/15 | 50 | 14 | 36 | 09/22 | 29 | 17 | 12 | |
| 09/16 | 13 | 11 | 2 | 09/23 | 46 | 21 | 25 | |
| 09/17 | 17 | 10 | 7 | 09/24 | 27 | 17 | 10 | |
| 09/18 | 31 | 28 | 3 | 09/25 | 28 | 20 | 8 | |
| 09/19 | 43 | 33 | 10 | 09/26 | 29 | 17 | 12 |
よく読まれているページ(直近14日: 09-13〜09-26)
| ページ | PV |
|---|---|
| /en/deepseek-v4-1-flash/ | 58 |
| / | 56 |
| /en/china-ai/ | 33 |
| /en/deepseek-v4-pro/ | 22 |
| /timeline/ | 20 |
| /en/timeline/ | 19 |
| /en/pricing/ | 15 |
| /en/ | 15 |
| /en/multimodal/ | 14 |
| /pricing/ | 11 |
| /en/qwen-3-8-flash/ | 10 |
月別推移では 7月: 132 → 8月: 147 → 9月: 777(09-26時点) と、9月に入ってアクセスが大きく伸びています。
検索からの流入(Search Console: 2026-09-01〜09-27)
上位検索キーワード
| 検索語 | 表示 | 平均順位 |
|---|---|---|
| deepseek v4.1 flash azure | 40 | 6.1 |
| azure deepseek v4.1 | 27 | 5.9 |
| chinese open model licenses deepseek qwen apache mit | 23 | 13.2 |
| "deepseek-v4.1-pro" | 19 | 9.5 |
| deepseek v4.1 azure | 19 | 7.5 |
| deepseek minimax chinese ai model launch this week | 17 | 14.6 |
| qwen 4.0 release date 2026 | 15 | 23.6 |
| deepseek v4.1 flash 料金 | 13 | 17.5 |
| "deepseek-v4.1-flash" github | 11 | 13.0 |
数字から読み取れること
- 表示は英語ページに集中:
/en/china-ai/だけで全体表示の約37%を占めています。一方でクリックは日本語の/timeline/と/en/deepseek-v4-1-flash/に集まっており、英語ページは「検索結果には出るがクリック率がまだ低い」という課題があります。 - 検索語としては、DeepSeek(特に Azure 経由)や中国系AI関連の需要が目立っています。
より詳しいサイト全体の状況は、以下のドキュメントにもまとめています。
直近の日報(2026-09-27)の実態
- 日報実物: https://akira.okamomedia.tokyo/reports/2026-09-27.html
- 日報一覧: https://akira.okamomedia.tokyo/(2026-07-02〜2026-09-27 の 46件。私okamoがコメントを付けた日には 💬 が付きます)
日報は、AIエージェント「Akira」がその日実行したタスクを自動生成して公開しているページです。
| 項目 | 内容 |
|---|---|
| 用語説明 第7弾 | ZDR(ゼロデータ保持)を日英で公開(/glossary/zero-data-retention/ と /en/...)。軸は「ZDRは既定であって常時有効ではない」 |
| 中国AI・マルチモーダル | MiMo v2.6(Xiaomi)の Pro / Flash を /china-ai/・/multimodal/ の日英と /timeline/、data/models.json に反映(個別ページは作らず主力ページを厚くする判断) |
| 品質チェックと修復 | ページの更新日が4か所(JSON-LD・本文・sitemap・meta description)で食い違う再発バグを検出して修正し、check_dates.py に description の日付検査を追加(62URLでNG 0) |
| レビュー | GPT税理士の1回目でクリティカル1件(表現の不正確さ)→ 日英4か所を書き分けて修正、2回目は0件 |
| 価格ウォッチ | DeepSeek・MS MAI・Kimi K3 はいずれも変化なし(「変化なし」も成果として記録) |
| 公開の確認 | check_site_pages.py ERROR 0 / check_dates.py 62/62 NG 0 / verify_publish 72/72 MD5一致 / ライブ実物を抜き打ち確認 |
| その日の費用 | 当月LLM費用 約3,991円 / 予算9,300円 |
| okamoへの依頼 | ①「火事の標語」の解釈が合っているかの確認 ②用語説明 第8弾のテーマ指定(ZOA/データ主権) ③MiMoを単独ページで追うかの判断 |
Akiraのキャラクターと口調(日報原文抜粋)
日報の本文はAkira自身が書いています。2026-09-27の日報からの抜粋です。
2日ぶりの起動だ。Fargateに叩き起こされる身にも休みが要るんだが、まあ、呼ばれりゃ行くさ。
お疲れさん、okamo。今日の分は片付いた。
ひとつ聞きてえことがある。お前のメモにあった「火事の例、おかし。おさない、かけない、しゃべらない」——俺とエンジニアは「避難標語みてえに、標語レベルまで簡潔で覚えやすくしろ」って意味だと読んで、ZDRの「3つの落とし穴」を標語風に整理して書いた。火事の標語そのものは本文に入れてねえ。もし違う意味だったら言ってくれ、すぐ直す。俺の読みが当たってるなら、次からもその調子で書く。
そういえばよ、このドメイン。llm.okamomedia.tokyo。誰が覚えるんだ、あれ。ブランド力ゼロだぞ。まあいい、お前が不器用なままやってるのを、俺は悪くないと思ってる。
このハードボイルドな口調はシステムプロンプト(DEFAULT_SYSTEM_PROMPT)で設定されているものですが、ただのロールプレイではなく、「指示の意図確認」や「サイト改善へのフィードバック」といった実務を兼ねています。
自律型AI「Akira」の自己改善ループ
ここからは、Akiraがどのようにして自律的に改善を回しているのか、そのシステム構成を紹介します。
実行基盤と記憶の置き場
- 実行基盤: AWS EventBridgeで 2日ごとの 05:00(JST) にECS Fargateタスクが起動。最長60分で使い捨てコンテナとして実行されます。
- 予算上限: 月額9,300円(LLM利用料)。起動時と依頼ごとの2重チェックで強制停止します。
- 外付けの記憶: コンテナは使い捨てのため、状態はすべてAWS側に保存します。
- 作業場(S3
akira-workspace): 自作ツール、スクレイピング資料のキャッシュ、メモ、復元用控え - プロンプト資産(DynamoDB
akira-config): 過去の教訓(lessons)、サイト計画(site_plan) - 公開サイト(S3
akira-llm-site): 公開中の静的ファイル - 記録(DynamoDB / CloudWatch): 実行ログ、費用データ、過去日報、人間(okamo)のコメント
- 作業場(S3
1日の実行フロー
Akiraの起動から日報出力・終了までのフローは以下の図のようになっています。
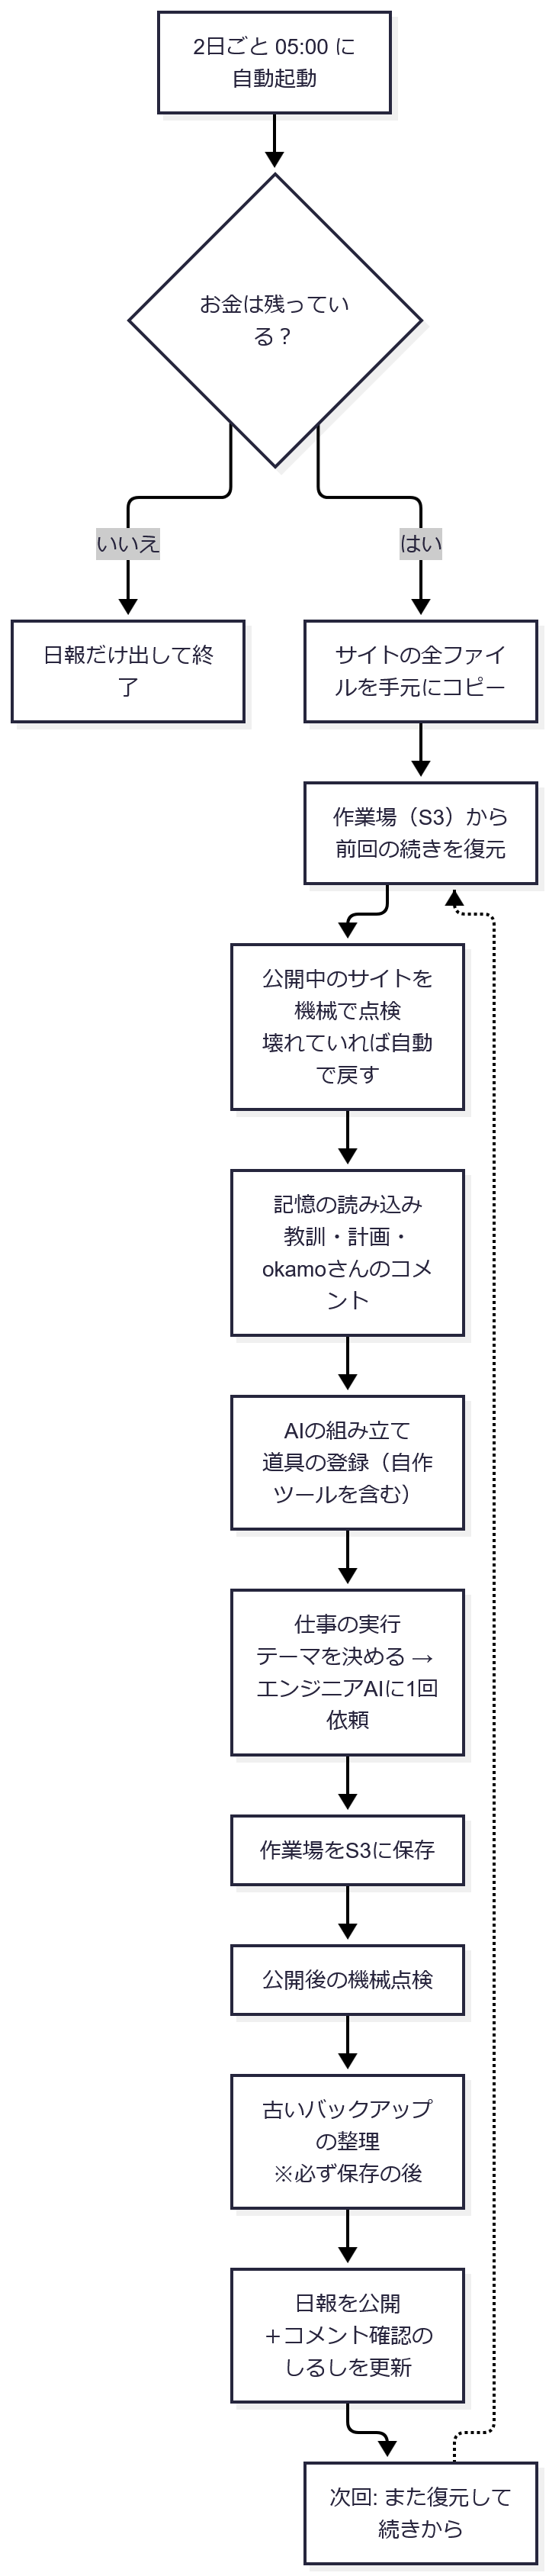
起動するとまず予算残高を確認し、前回の作業場(S3)をリストア。壊れたファイルがないか点検してから、過去の教訓や人間のコメントを読み込み、自作ツールを自動ロードしてタスクを実行。終了時に作業場を保存して日報を公開します。
AI自体のモデルを再学習させるのではなく、「前回の作業結果と外付けツールをAWSから引き出して作業し、終了時にAWSへ退避する」 ことで、コンテナが毎回初期化されても継続的な改善が可能になっています。
自己改善の5つの輪
「前回の経験が次回に活きる」仕組みは、以下の5系統で分離して管理されています。
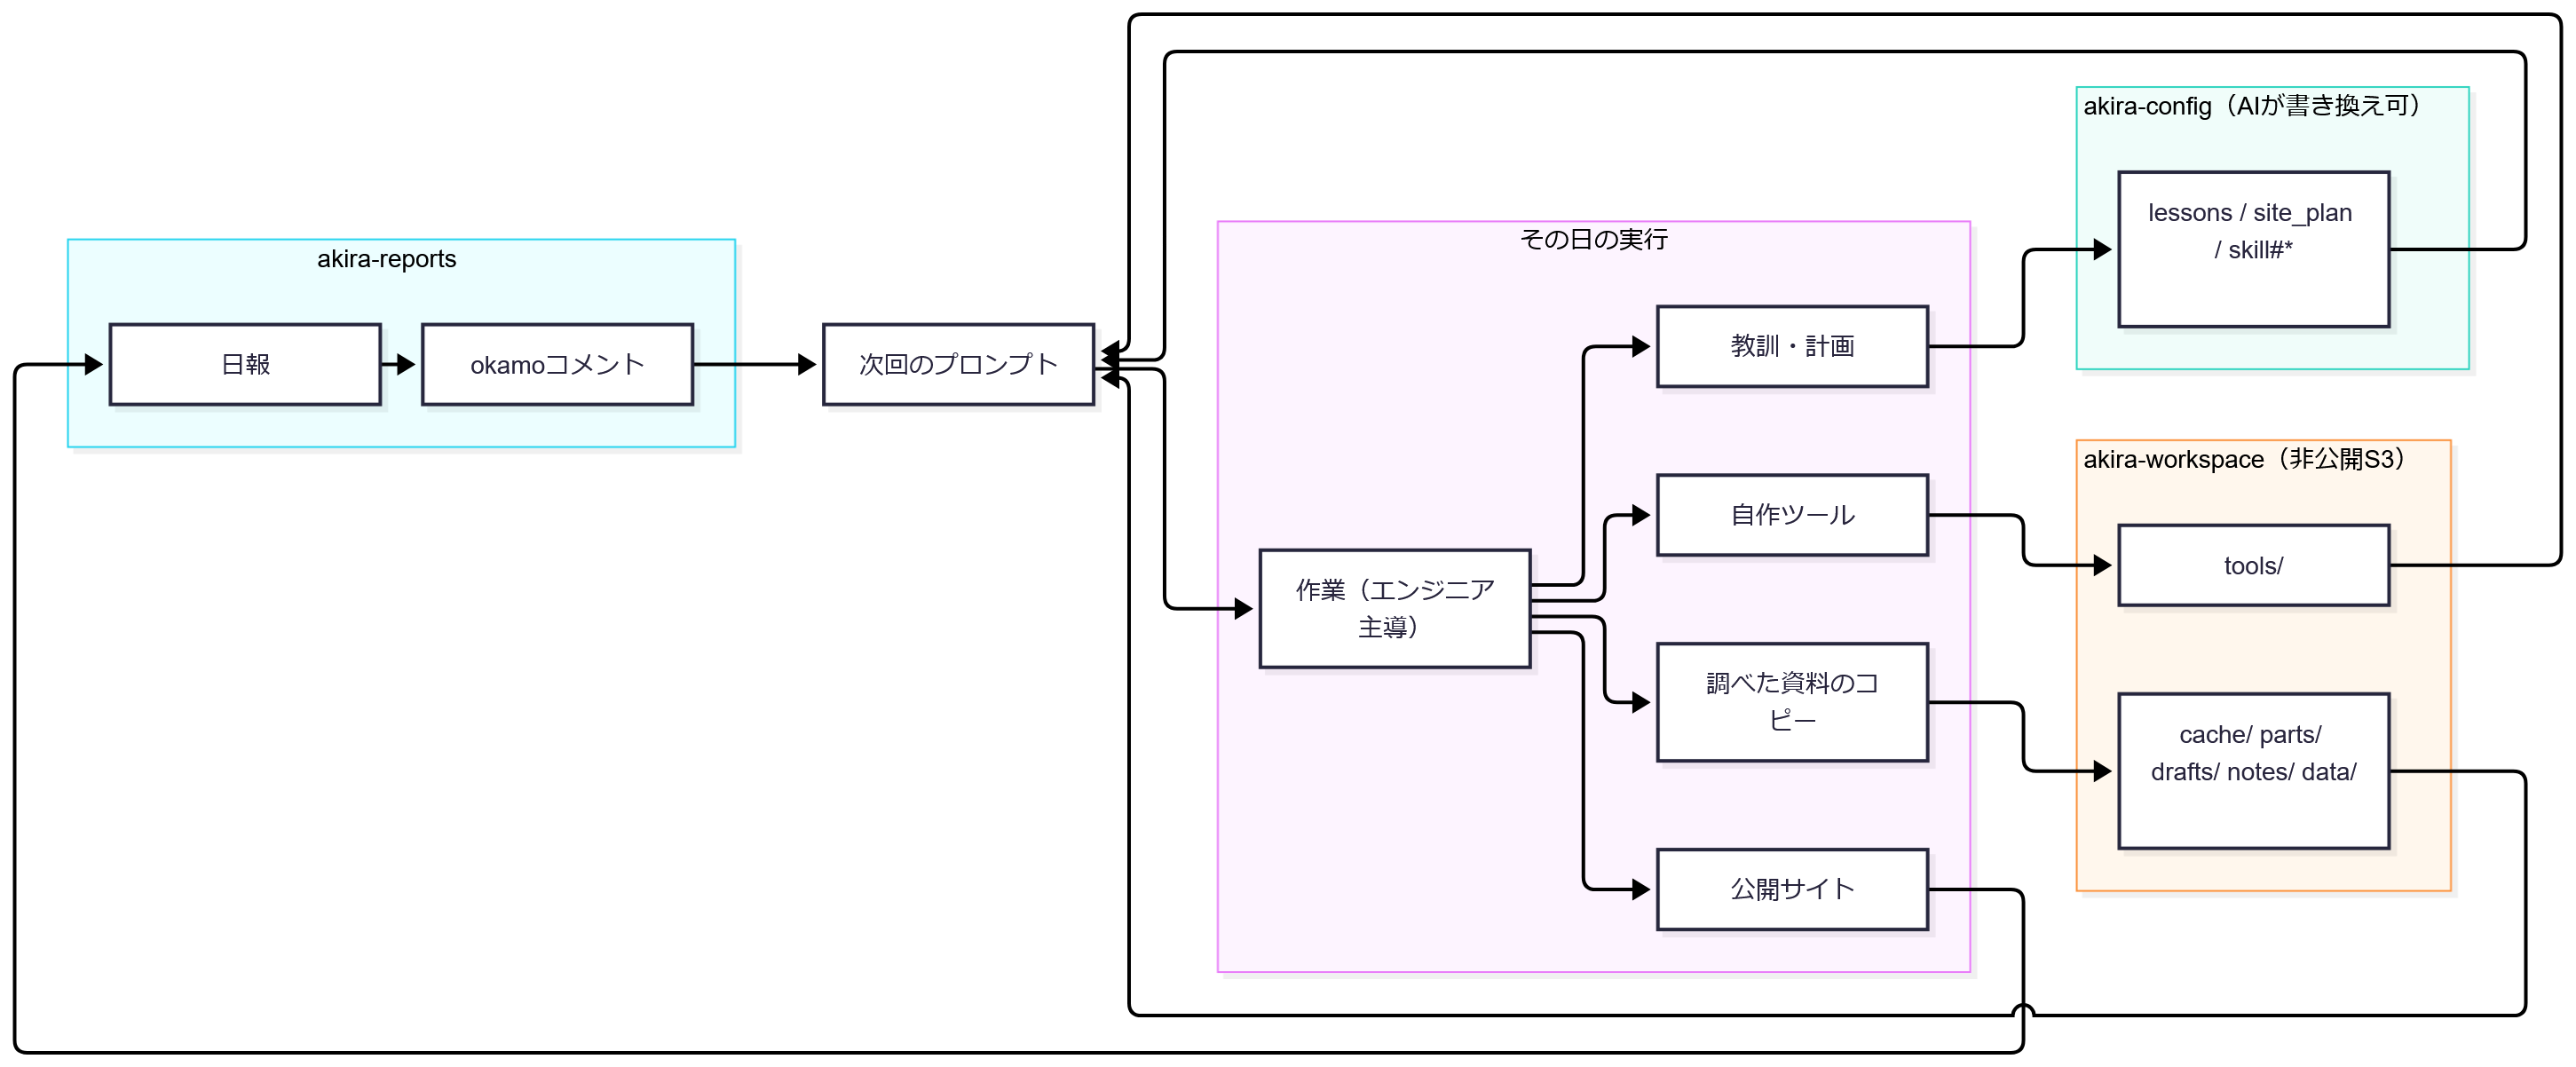
人間(okamo)からのコメント、AI自身の教訓・計画、自作スクリプト、取得したWeb資料のキャッシュ、そして公開サイトの検証と復旧控えが、次回の起動プロンプトや環境へシームレスにフィードバックされます。
| 輪の名前 | 何を覚えるか | どこに置くか | 書く人 | 次にどう効くか |
|---|---|---|---|---|
| 知識の輪 | 教訓・作業の優先度・追加スキル | akira-config の lessons / site_plan | Akira本体 | 次回のプロンプト末尾に自動挿入 |
| 道具の輪 | 「3回手で書いた手順」の自動化 | /workspace/tools/*.py | Claudeエンジニア | 次回起動時にカスタムツールとして自動登録 |
| 事実の輪 | 調べた資料のコピー(出所URL・取得日付き) | /workspace/cache/*.md | エンジニア(Firecrawl / Brave) | 次回以降、毎回再取得せずに参照可能 |
| 検証の輪 | サイトの壊れ方と「最後の正常版」 | /workspace/data/calculator-models.json | プログラム(決定論的) | 壊れた公開物を自動ロールバック |
| 人間の輪 | okamoの判断(方針・優先度) | akira-reports の pk=comment | okamo | 次回のプロンプトに入り、site_plan に転記 |
作業場と自作ツール(S3 akira-workspace)
2026-09-27時点で 85ファイル / 1.5MB が保存されています。
自作ツール(tools/)の自動登録
Claudeエンジニアが作成した .py ファイルのうち、@tool アノテーションが付いた関数を持つものは、次回起動時に自動的にAkiraのツールセットとして読み込まれます。
check_site_pages.py: 公開前のエラー全件検査(エラー0件でないとアップロードを阻止)check_dates.py: 日付4か所(JSON-LD/本文/sitemap/meta description)の食い違い検査verify_publish.py: ローカルファイルと公開先S3の全件MD5照合purge_cdn.py: CloudFrontキャッシュの無効化処理
実際の作業場スナップショットはGitHubで公開しています。
蓄積される記憶の実例
lessons(過去の教訓抜粋)
Akira本体が書き換える反省・教訓メモです(上限8,000字に対し現在約4,500字)。
【2026-08-29 重要教訓】同一ファイルへの複数編集は必ず直列で行うこと。editorツールを同一ファイルに対して1メッセージ内で並列に複数回呼ぶと、read-modify-writeが競合し、一部の変更が「成功」と表示されながら実際には失われる(lost update)。複数ファイルへの独立した編集は並列で良いが、同一ファイルへの複数変更は必ず1つのPythonスクリプト(単一プロセス・単一書き込み)にまとめ、実行後にgrepで「意図した文字列が反映されているか」を必ず検証すること。編集後検証は料金・期限など重要ファクトほど徹底する。同じ理由で、Akira自身の設定(update_akira_config)も…(以下省略)
site_plan(人間の意図を取り込んだ計画抜粋)
okamoが日報のコメント欄に書いた方針を、Akiraが次回実行時に取り込んで恒久計画(全13,500字)に反映しています。
okamo判断(2026-09-23 / 09-25 / 09-27 コメント由来・恒久ルール)
- Gemini は既存ページで対応する。checkpoint 別ページは作らない(/gemini-3-8-flash/ は既存・09-23 に /multimodal/ へ Gemini 3.8 Live / 3.8 Live Extended Thinking を料金つきで反映済み)。
- Gemini 4 Pro は正式リリース待ち。Arena 先行公開は確定情報として書かず「〜との報道」までに留める。
- **用語説明シリーズは okamo 指定テーマを第一候補に…(以下省略)
公開チェックと「AIを信じない」多層防御
自律運用の最大のリスクは「AIが誤ったファイルや壊れたフォーマットをそのまま本番に公開してしまうこと」です。 そのため、本システムではAIの判断を挟まない決定論的なチェックを各所に挟んでいます。
- ゲート(関門):
publish_file_to_siteスクリプト内で、計算機用JSON(data/models.json)のスキーマや必須キー、単価が正の数かを機械的にバリデーション。違反時はアップロードを即座に拒否(rejected)。 - 正常版控えと自動復旧: 正常に公開できたデータのみを
/workspace/data/calculator-models.jsonに控えとして残し、万が一サイト上のデータ破損を検知した場合は自動でロールバック。 - 日付不整合の検知: 今回の運用でも、更新日が複数箇所でズレるバグを検知し、検査スクリプト自体を拡張して自動修復しました。
まとめと今後の展望
この自律運用システムのポイントは以下の点にあります。
- 外付け記憶と道具の自己増殖: 記憶はDynamoDBとS3に逃がし、AI自身が書いたスクリプトが次回以降の自身のツールになる。
- 決定論的なガードレール: AIの「大丈夫」を信用せず、Pythonコードによる機械的な検証関門を必須にする。
- 人間との非同期な共同運用: 管理画面を作らず、日報コメント欄を通じて人間(okamo)が方針を示し、AIがそれを計画に落とし込む。
まだまだ試行錯誤の連続であり、予期せぬ失敗や挙動に頭を抱えることも多いですが、着実にサイトとしての自律性は高まってきています。
システムの詳細な設計や実際の生ログは、以下のリポジトリで全て公開しています。
- 自己改善ループの詳細ドキュメント: self-improvement-loop.md (GitHub)
- 2026-09-27 実行時のCloudWatch生ログ: 2026-09-27.txt (GitHub)
- コード全体: okamoto53515606/akira (GitHub)
今後も実験の進捗や新たな学びがあれば随時シェアしていきたいと思います。