okamomedia.tokyo(okamoワールド)に、また新しいWebツールが仲間入りしました!
その名も 「rm」 。 写真の顔、車のナンバープレート、開発画面スクショのAPIキーや機密テキストを、サーバーや外部API(Gemini等)に画像を一切送信せず、ブラウザ上だけで自動検出&マスクできるツールです。
- 公開URL: https://rm.okamomedia.tokyo/
- GitHub(ソースコード全公開・MITライセンス): https://github.com/okamoto53515606/rm
私は、「プロダクト開発において大事なのは技術力そのものよりも『Why(なぜそれを作るのか)』である」 と考えています。今回は、このツールが生まれた背景と、外部APIに頼らず「完全ブラウザ完結」でナンバープレートやAPIキー検出を実現するまでの試行錯誤をご紹介します。
開発のきっかけ:源さんの記事と「小さなモデル」へのリスペクト
始まりは、源 勝(みなもと まさる)さんのnote記事でした。
源さんは記事の中で、153.6MBという驚くほどコンパクトなアプリがM1 Mac(メモリ8GB)かつ完全オフラインで軽快に動く様子をレビューされていました。そして記事の最後で、次のように綴られていました。
「それでも、こういう小さなモデルを選び、実際に使える製品に仕上げている人や企業は、ほんと尊敬してしまいます。 なんというか、でっかい高性能な最新モデルを使えば何でもできる! という流れに、別の方向から挑んでいるように見えるんですよね。 ちょっとロックな感じというか、反骨精神というか。🎸」
この「巨大な最新モデルに頼り切るのではなく、小さく最適化されたモデルを工夫して届ける姿勢こそが圧倒的にカッコいい」という源さんの言葉に、私は痺れました。
noteのコメント欄で起きた、小さなストーリー
感動した私がコメント欄で「写真の顔やAPIキーを隠す作業が面倒なので、ブラウザですぐ使えるOSSがあったら便利そう」とお伝えしたところから、やり取りが始まりました。
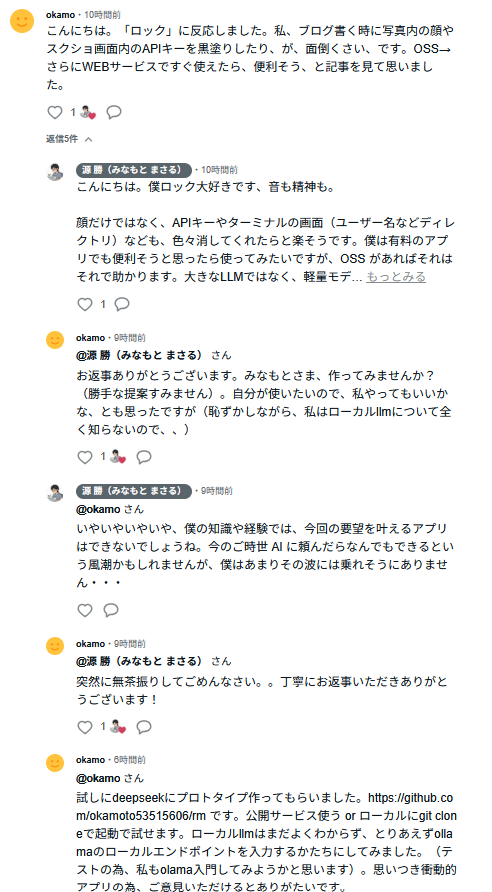
上記の画像は、源さんとの実際のコメントのやり取りです。
- 10時間前: 私が「ロックに反応しました。顔やAPIキーを消すOSSのWebサービスがあったら便利そう」とコメント。
- 10時間前〜9時間前: 源さんから「大きなLLMではなく軽量モデルで動くOSSがあれば助かる。でも自分の知識や経験では作れないかも」とお返事をいただく。
- 6時間前: 私が「試しに作ってみました!」とGitHubプロトタイプのURLを返信。
着想からプロトタイプ公開までわずか数時間。源さんのロックな言葉に背中を押され、「Why(誰かの困りごと、実現したい世界)」が明確になったので、迷いなく開発が進みました。
ツールの名前「rm」に込めた2つの由来
ツールの名前はシンプルに 「rm」 と名付けました。これには2つの意味があります。
- remove: 写真やスクショからプライバシー情報(顔・ナンバー・機密情報)を綺麗に取り除くこと。
- rock minamoto: 小さなモデルの可能性と反骨精神を熱く語ってくださった、源さんの「ロック精神」へのリスペクト。
Linuxコマンドの「rm(削除)」にも通じる、無駄のない名前に仕上がっています。
「完全ブラウザ完結」でナンバープレート検出を実現するまでの苦闘
当初は外部API(Gemini)を利用していたテキストやナンバープレート検出ですが、「源さんのロック精神を受け継ぐなら、通信を一切発生させずブラウザ内蔵の処理だけで完結させたい!」と思い立ち、アップデートを行いました。
しかし、ブラウザ上で動く軽量OCR(Tesseract.jsなど)で高解像度写真からナンバープレートを抜き出すのは、想像以上に大変でした。
直面した壁:小さすぎる文字と遅すぎる処理速度
- Tesseractは「全体に対して小さい文字」を無視する スマホで撮った 4032×3024 などの写真では、ナンバープレートは全体の面積のわずか1%程度しかありません。全体をどれだけ拡大しても、OCRのページ分割の段階で「文字がない」と判断されて弾かれてしまいます。
- 総当たりで分割拡大すると激重になる 画像を4分割して拡大し、日本語モデルで読み込ませてみると、1枚あたり10〜20秒もかかってしまいます。しかもテクスチャの多い写真ほど遅くなり、それでも誤認識・不検出が多発しました。
解決策:「先にプレート領域を探し、そこだけ切り抜いて読む」
そこで、アプローチを根本から変えました。いきなりOCRをかけるのではなく、軽量な画像処理で「プレートがありそうな場所を絞り込んでからピンポイントで読む」方式です。
- 積分画像による高速探索: 白さ(RGBの最小値)の積分画像を作成し、横長の明るい長方形領域を探します。
- しきい値判定で矩形を確定: 見つかった領域をしきい値を超える範囲まで広げてプレートの矩形を決定。
- ピンポイントOCR(0.1〜0.4秒): その部分だけを元解像度から切り出し、幅700px程度にリサイズしてOCRへ投入。これにより処理時間が一気に高速化しました。
- 待ち時間最優先(リトライなし): 候補は1つだけ試します。読めなければそれ以上粘らず潔く諦めることで、UIのサクサク感を維持しました。
- 下段番号を手がかりに全体を隠す: 上段の「地名+分類番号」は文字が小さく誤読しやすいため、下段の大きな一連指定番号を手がかりに判定し、隠す枠はプレート全体を覆うように設定しています。また、PSM(ページ分割モード)も全体探索と切り出し時で使い分けています。
※そのため、写真の傾きが強すぎる場合や、プレートが極端に小さい場合、夜間で白飛び・黒つぶれしている写真では検出できないことがあります。その場合は、フォールバックとして「ローカルLLM検出」を選択いただくか、手動での枠追加をご利用ください!
実際の画面と進化した機能
ブラウザ完結(無通信)で動作する最新の画面をご紹介します。
1. 検出と編集のメイン画面
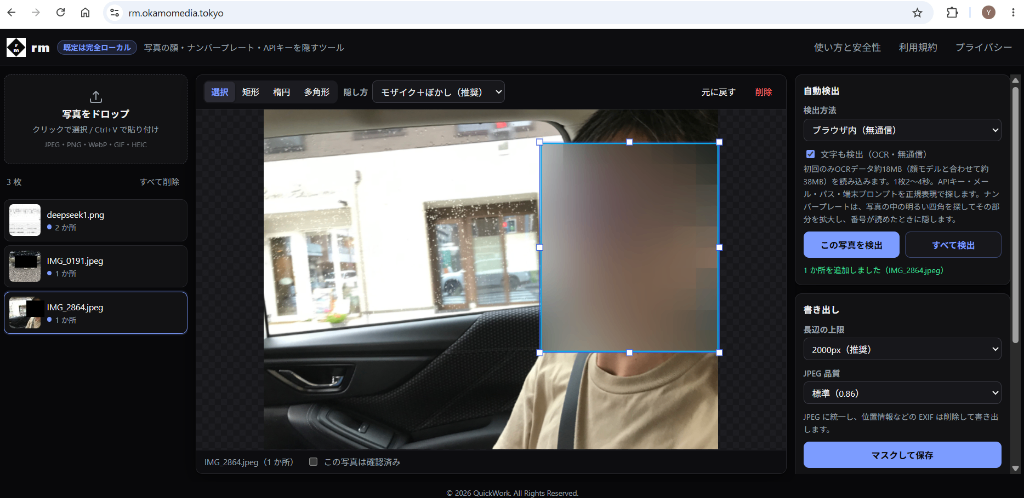
画面は直感的なダークテーマ。写真をドラッグ&ドロップ(または Ctrl+V でスクショ貼り付け)するだけで読み込まれます。右側のパネルから「ブラウザ内(無通信)」を選択した状態でも、顔だけでなく「文字も検出(OCR・無通信)」にチェックを入れることで、APIキーやナンバープレートのローカル検出が走ります。
2. 顔の自動検出&モザイク+ぼかし
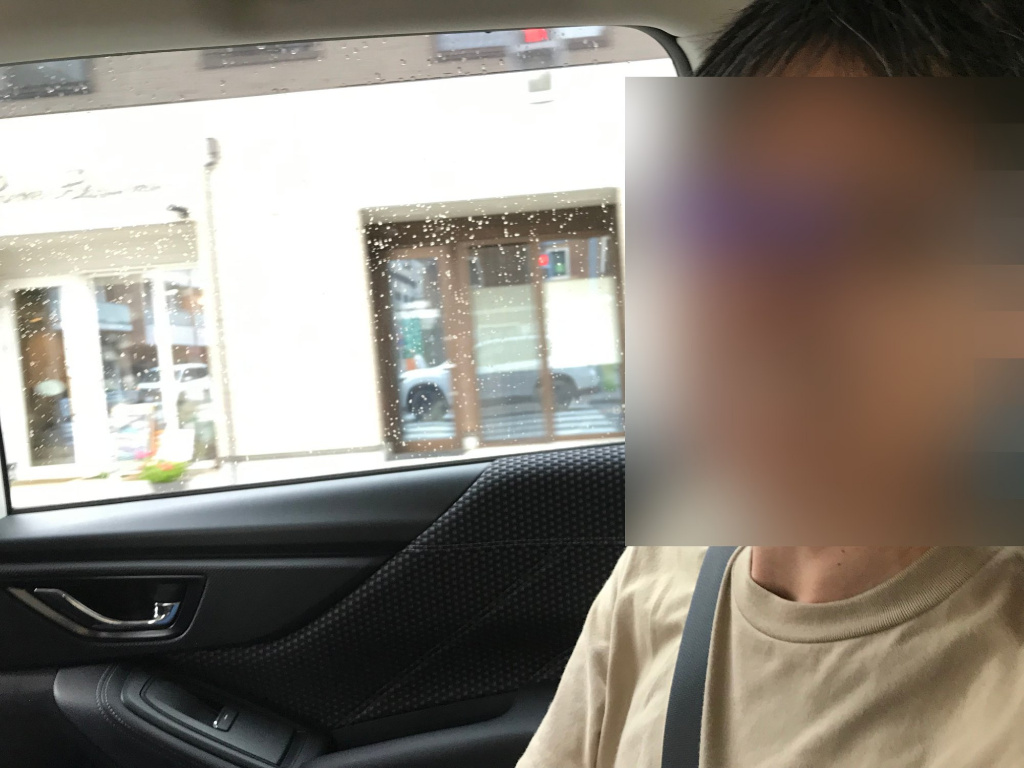
MediaPipeの478点ランドマーク補正により、車内などで撮影した人物の顔も正確に把握し、タイトにモザイク+ぼかし処理を施します。
3. 車のナンバープレート検出(完全ブラウザ完結)
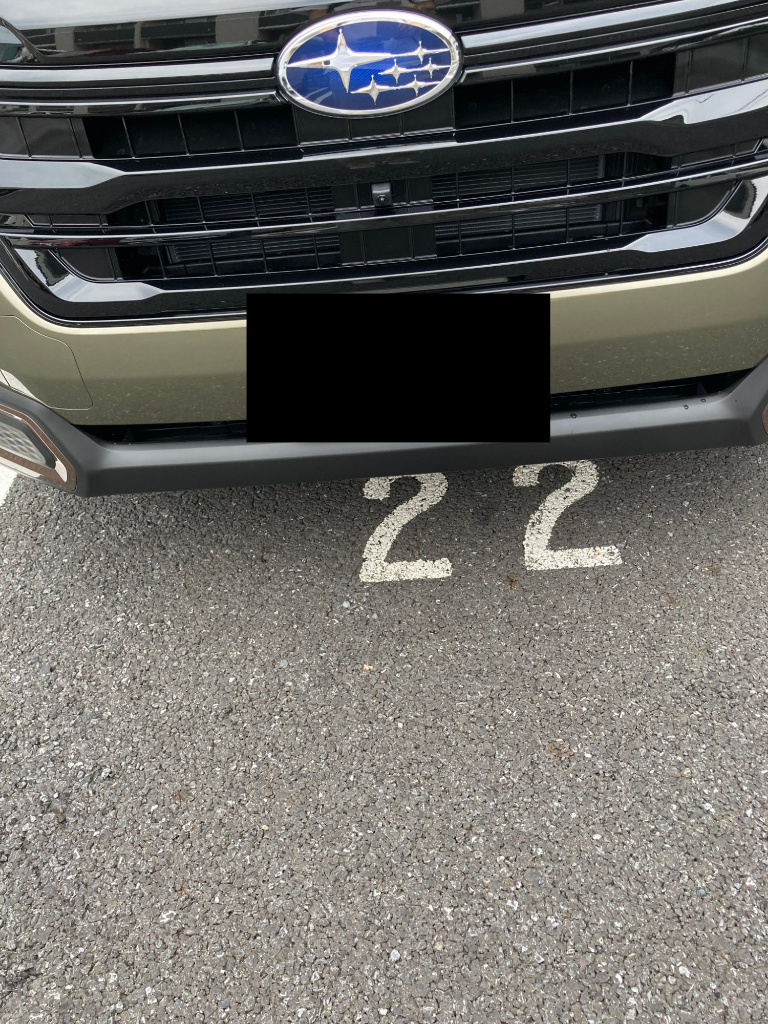
外部APIを一切通さず、ブラウザの画像解析と局所OCRの合わせ技でナンバープレートを自動認識し、黒塗りマスクを適用します。
4. APIキーや機密文字列の黒塗り(完全ブラウザ完結)
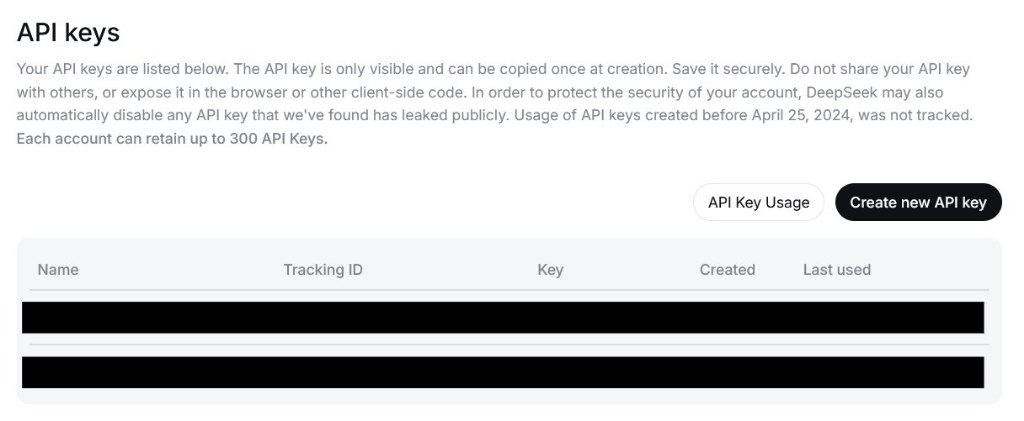
管理画面のスクショに含まれるAPIキーなども、正規表現パターンとOCRを組み合わせることで、ローカルブラウザ内だけで綺麗に隠すことができます。
5. うっかり流出を防ぐ「書き出し前の確認アラート」
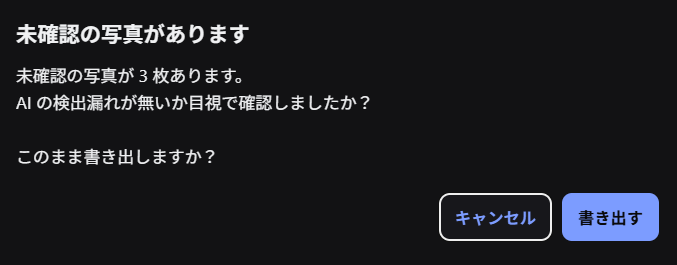
複数枚の写真をまとめて処理する際、AIの検出漏れを目視確認しないまま書き出してしまうリスクを防止するため、「未確認の写真があります」という確認アラート機能を新たに追加しました。大切な情報をうっかり公開してしまう事故を未然に防ぎます。
なお、書き出し時はHTML5 Canvasを通して再エンコードするため、写真の位置情報(GPS)や撮影日時などのEXIF情報も自動的に綺麗に消去されます。
使い方:Web版でも、git cloneのローカル環境でも!
① 今すぐWebで使う(インストール不要)
ブラウザで https://rm.okamomedia.tokyo/ を開くだけです。
- 写真をドロップまたは貼り付け(複数枚OK)
- 「ブラウザ内(無通信)」を選んで検出を実行
- プレビューを確認し、枠の微調整を行ったら「マスクして保存」
② ローカル環境で動かす(git clone)
git clone https://github.com/okamoto53515606/rm.git
cd rm
./scripts/dev.sh
ローカル環境なら、完全に社内ネットワークやオフライン環境に閉じ込めた状態で安全に利用できます。
おわりに
「でっかい最新モデルを使えば何でもできる時代に、小さく最適化された仕組みで立ち向かう」。源さんの熱い言葉から始まった「rm」は、OCRアルゴリズムの工夫によって、サーバー通信なしでナンバーやAPIキーまで隠せるツールへと進化しました。
ブログやSNSの投稿前、開発ドキュメント作成時のマスキング作業に、ぜひ役立ててみてください!