皆さん、こんにちは。okamoです。
まず初めに、当Webサイト(https://www.okamomedia.tokyo/)において、長期間にわたりアクセスできない障害が発生し、訪問してくださった皆様に多大なご不便とご迷惑をおかけしましたことを深くお詫び申し上げます。
約5日半にわたってサイトが閲覧不能な状態となっておりました。現在は復旧作業および再発防止策の適用を完了し、正常に稼働しております。
本記事では、読者や利用者の皆様への状況のご報告とお詫びを兼ねて、「どこで何が起き、なぜ5日間も気づけなかったのか」、そして「根本原因と今後の対策」について技術的な詳細も含めて透明性を持ってお伝えします。
同じ構成(CloudFront + Lambda Web Adapter + ECR)でWebサービスを運用されている開発者の方にとっても、同じ事故を未然に防ぐための参考になれば幸いです。
結論(先に3行でまとめ)
- 原因: Next.jsアプリを動かすLambda(
homepage-app)が起動時に参照するDockerイメージが、ECRから消えていたため起動できず、全ページで502 Bad Gatewayが発生していた。 - 復旧: アプリコードの不具合ではなく、同じコミットからDockerイメージを再ビルドしてECRへ再登録・差し替えるだけで復旧完了(作業時間約15分)。
- 引き金: コスト削減のために良かれと思って設定したECRの「最新5イメージのみ保持」ライフサイクルポリシー。しかしそのECRリポジトリはCDK bootstrap共通で3プロジェクトが相乗りしており、他プロジェクトのデプロイによって本番イメージが押し出されてしまっていた。
障害の概要
- 対象: 本番サイト
https://www.okamomedia.tokyo/(homepage v2) - 障害期間: 2026年10月24日 22:00頃 ~ 2026年10月30日 05:47(日本時間、約5日半)
- 影響範囲: トップページ、記事ページ、管理画面、APIなどWebサイト全体へのアクセス不可(一部キャッシュ画像を除く)
- ソースコード変更: なし(
mainブランチのv2.1.0から再ビルドして復旧)
1. 利用者から見えていた症状
障害発生中、ブラウザからサイトにアクセスすると以下のような英語のエラーメッセージのみが表示される状態となっていました。
{"Type":"User","message":"The server encountered an error and could not complete your request"}
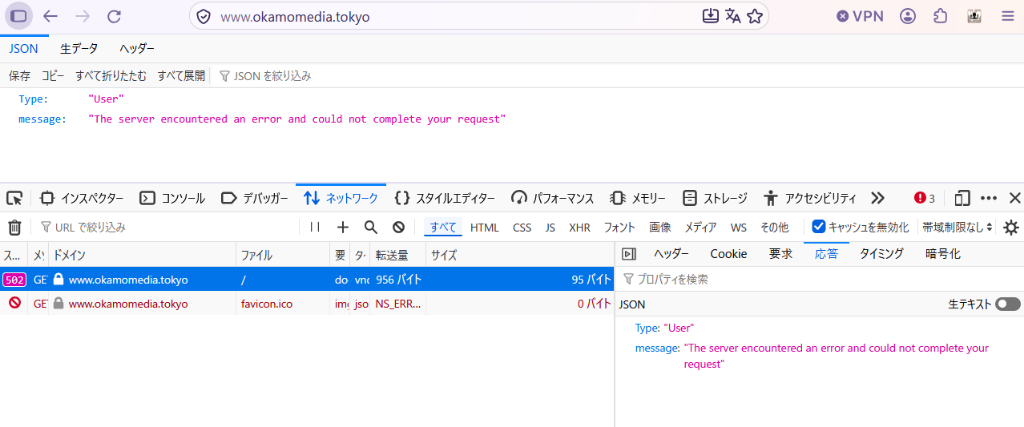 ブラウザの開発者ツールで確認されたエラー。CloudFrontが返す汎用の 502 Bad Gateway となり、JSON形式のエラーメッセージが返却されていた
| 見え方 | 実際に起きていたこと |
|---|---|
| トップページに英語のエラーメッセージが表示される | サイトのバックエンドプログラム(Lambda)が起動できず、中継役であるCloudFrontが汎用エラー(502 Bad Gateway)を返していた |
| ページによっては画像だけ正常に表示された | 画像ファイルはS3オリジン(/media/*)から直接配信していたため無事だった |
| 管理画面・APIも同じエラー | 同一のLambdaコンテナが担当しているためすべてアクセス不可 |
エラー率(日次平均)の推移
CloudFront側でのエラー率(サーバーエラーを返した割合)の推移は以下の通りでした。
| 日付 | エラー率(日次平均) | 状況 |
|---|---|---|
| 10/22〜10/23 | 0% | 正常稼働 |
| 10/24 | 12% | この日の22時頃から急激に発生 |
| 10/25 | 66% | 障害継続 |
| 10/26 | 73% | 障害継続 |
| 10/27 | 86% | 障害継続 |
| 10/28 | 72% | 障害継続 |
| 10/29 | 89% | 障害継続 |
| 10/30 05:47 以降 | 0% | 完全復旧 |
なぜエラー率が100%にならなかったのか? サイト内の画像(S3直参照)や、エッジキャッシュに残っていた静的リソースは正常に200 OKを返していたためです。この「一部だけ動いているように見える」状態が、かえって問題の特定を遅らせる要因にもなりました。
2. システム構成と障害のメカニズム
本サイトの基本アーキテクチャ
当サイトは、AWS上で以下のようなサーバーレス構成を採用しています。
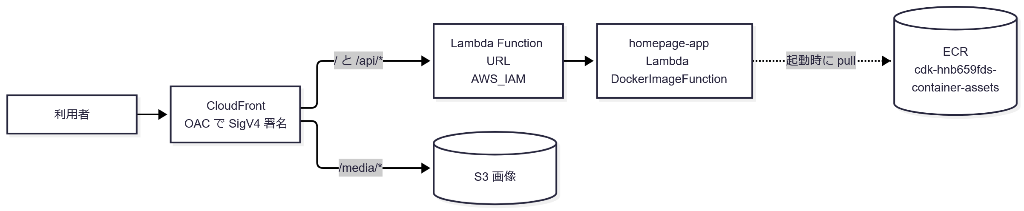 利用者のリクエストがCloudFront経由でルーティングされ、Next.jsをホストするLambdaがECRからコンテナイメージをpullして実行される構成
- Next.js アプリケーション: Dockerイメージとしてビルドし、Amazon ECR(コンテナレジストリ)に保存。
- AWS Lambda(DockerImageFunction): Lambda Web Adapter を利用し、DockerコンテナとしてNext.jsを実行。
- CloudFront + Lambda Function URL: CloudFrontからOAC(Origin Access Control)によりSigV4署名を行ってLambda Function URLをセキュアに呼び出す。
- 画像アセット:
/media/*はS3バケットをオリジンとして配信。
ここで極めて重要なのは、「Lambda(DockerImageFunction)は、起動時にECRからイメージをpullする」という前提です。ECR上のイメージは、単なるデプロイ時の成果物ではなく起動に必須の実行ファイルそのものでした。
今回発生した事象の流れ
1. ECR リポジトリ(cdk-hnb659fds-container-assets-...)に
   「最新5イメージのみ保持」の手動ライフサイクルポリシーが設定されていた
        ↓
2. 実はこのリポジトリはCDK bootstrapが自動作成した「アカウント・リージョン共通」の置き場。
   homepage-v2 / Newcleus(CMS) / ショットバーHP の 3プロジェクトが相乗りしていた
        ↓
3. 10/24 午後、他2プロジェクトのデプロイにより新しいイメージが合計5個 push された
        ↓
4. 10/24 22:00頃、ECRの日次ライフサイクル評価が走り、
   homepage-app の本番イメージが「最新5個」の枠から押し出されて消滅(失効)
        ↓
5. Lambda homepage-app が「State=Inactive / StateReasonCode=ImageDeleted」へ遷移
        ↓
6. Lambda が1度も起動できず、CloudFrontが 502 Bad Gateway を返し続ける状態に
最大の盲点:Lambdaは「エラーを出していた」のではなく「起動すらできていなかった」
今回の障害で最も厄介だったのは、Lambda関数内で例外が発生したのではなく、「実行基盤そのものが立ち上がれなかった」点です。
そのため、アプリケーションログ(CloudWatch Logs)には1行もエラーが残らず、Lambdaメトリクスの Errors も 0 のままでした。実測したところ、CloudWatchの Invocations(呼び出し回数)は10/24の21時台を最後にピタリとゼロになっていました。
3. なぜ設定ミスが起きたのか?見落としていた4つの前提
「最新5イメージだけ残す」というライフサイクルポリシーは、ECRのストレージ課金(GBあたり月額)を抑えるための、「良かれと思って入れた容量対策」でした。発想自体はクラウド運用で一般的なものですが、以下の前提条件を見落としていました。
| 見落としていた前提 | 実際のAWSの挙動・事実 |
|---|---|
| ECRリポジトリが「共有」だった | CDK bootstrapで作成される cdk-hnb659fds-container-assets-... は、同一アカウント・同一リージョンで作成されたCDKアプリすべてで共有される。3つのプロジェクトが同じバケット/レジストリを使っていた。 |
| 「5個」の枠はリポジトリ全体 | ライフサイクルポリシーはプロジェクト単位ではなく、リポジトリ全体で件数をカウントする。別プロジェクトが5回pushすれば、自プロジェクトのイメージは押し出される。 |
| ECRは「稼働中か」を考慮しない | ECRのライフサイクル機能は「プッシュ日時・タグ・件数」しか見ない。Lambdaが現在参照しているイメージであっても容赦なく消去される。 |
| CDK既定の安全設定を上書きした | CDK bootstrap既定のライフサイクルは「untagged(タグなし)を365日で失効」という安全網だった。これを上書きしてしまったことで、本番タグ付きイメージが削除対象になった。 |
「このリポジトリは自分専用である」という誤った前提があったため、安全なはずの容量整理が「本番イメージの破壊」へと化けてしまったのが根本原因です。
4. なぜ5日間も気づくことができなかったのか
障害発生から復旧まで約5日半もの時間を要してしまった要因は、以下の複合的な理由によるものです。
- エッジ監視(5xx率)のアラームが未整備だった: Lambda内部のログ監視だけを意識しており、CloudFrontとLambdaの境界で発生する502エラーを検知するアラートが組まれていなかった(利用者のご報告で初めて発覚)。
- 静かに壊れる障害だった: デプロイ直後に壊れたのではなく、数日後の日次バッチ(ECRの評価タイミング)で突然壊れたため、コードの変更と結びつきにくかった。
- 一部のリソースが生きていた: 画像アセットはS3から正常配信されていたため、一見すると「通信の調子が一時的に悪いだけ」のように見えてしまった。
- CI/CDのテスト対象外: 自動テストは「コードの品質」を担保しますが、「デプロイ済みのECRイメージがストレージ上に実在し続けているか」までは監視できない。
5. 復旧作業と再発防止策
復旧作業(10/30早朝・約15分)
障害報告を受けてから原因特定、復旧までは迅速に行われました。
- 05:32: 外部からのアクセスで502エラーを再現・確認。
- 05:35: Lambdaコンソールにて
Inactive / ImageDeletedのステータスを確認し、ECRイメージ消失を特定。 - 05:40: コードの差分(ドリフト)がないことを確認し、本番コミット(
v2.1.0)からローカルでDockerイメージを再ビルド。 - 05:46: ECRへ再push。
- 05:47: Lambdaの参照先イメージを更新し、即座に
Activeに復帰。サイトが復旧。 - 05:50: 危険なライフサイクルポリシーをCDK bootstrap既定値へ差し戻し。
※ドメイン、SSL証明書、WAF、DB、アプリコード等には一切手を加えておらず、復旧作業に伴う二次障害や設定変更はありません。 また、配布中のWSLイメージやアプリコード自体に変更はないため、利用者側でのアップデート作業等の必要もございません。
実施した再発防止策
二度と同様の事態を引き起こさないため、以下の対策を恒久化しました。
① ECRライフサイクルポリシーを安全な設定へ戻す
件数による削除ルールを全廃し、CDK bootstrap既定の「タグなし(untagged)イメージのみを365日経過後に削除する」設定に変更しました。これにより、稼働中のタグ付きイメージが勝手に失効することは絶対にありません。
② CloudFrontとLambdaの2重アラーム監視をCDKスタックに追加
システムが「沈黙」した瞬間に即座に気付けるよう、監視用スタック(HomepageMonitoringStack / HomepageMonitoringEdgeStack)を新設しました。
- CloudFront 5xx率アラーム (
homepage-cloudfront-5xx-rate): 5xxエラー率が5%以上を10分間継続した場合に即座にSNS(メール)通知。今回のように「Lambdaが起動しない」場合でも確実に検知します。 - Lambda Errorsアラーム (
homepage-app-lambda-errors): Lambda関数で5分間に1件以上の例外が発生した場合に通知。
運用の教訓:システムは「運用してなんぼ」
今回のトラブルを通じて痛感したのは、「システムは運用してなんぼであり、運用して初めて気づくことが本当に多い」ということです。
開発環境やCIのテストがどれだけ100点満点であっても、複数プロジェクトが共存するクラウドアカウントの振る舞い、バッチで動くクリーンアップルールの挙動、そしてそれらが噛み合わなくなったときの「静かな壊れ方」は、実際に本番環境で運用し続けなければ見えてこないリアルな学びでした。
- 「件数上限」による自動掃除は安易に使わない(特に共有リソース)
- 「アプリが動いているか」だけでなく「インフラのエッジで正常に応答しているか」を監視する
- 正常に見える部分(画像など)があっても、まずは全体稼働状態を疑う
失敗は真摯に反省しつつ、こうした貴重な経験を糧にして、より堅牢で信頼できるシステム基盤へと成長させていくことが何より重要だと考えています。
改めまして、今回の障害によりご迷惑をおかけした皆様に心よりお詫び申し上げます。これからも日々の実運用を通して、サービスの改善と安定稼働に全力で取り組んでまいります。今後ともどうぞよろしくお願いいたします。